
조직 문화 진단과 같은 HR 서베이에서 주관식 응답은 정량 응답만으로는 알기 어려운 구성원의 경험과 맥락을 담고 있다.
문제는 하나의 응답이 반드시 하나의 주제나 감정만을 담고 있지는 않다는 것이다.
예를 들어 다음과 같은 응답이 있다고 해보자.
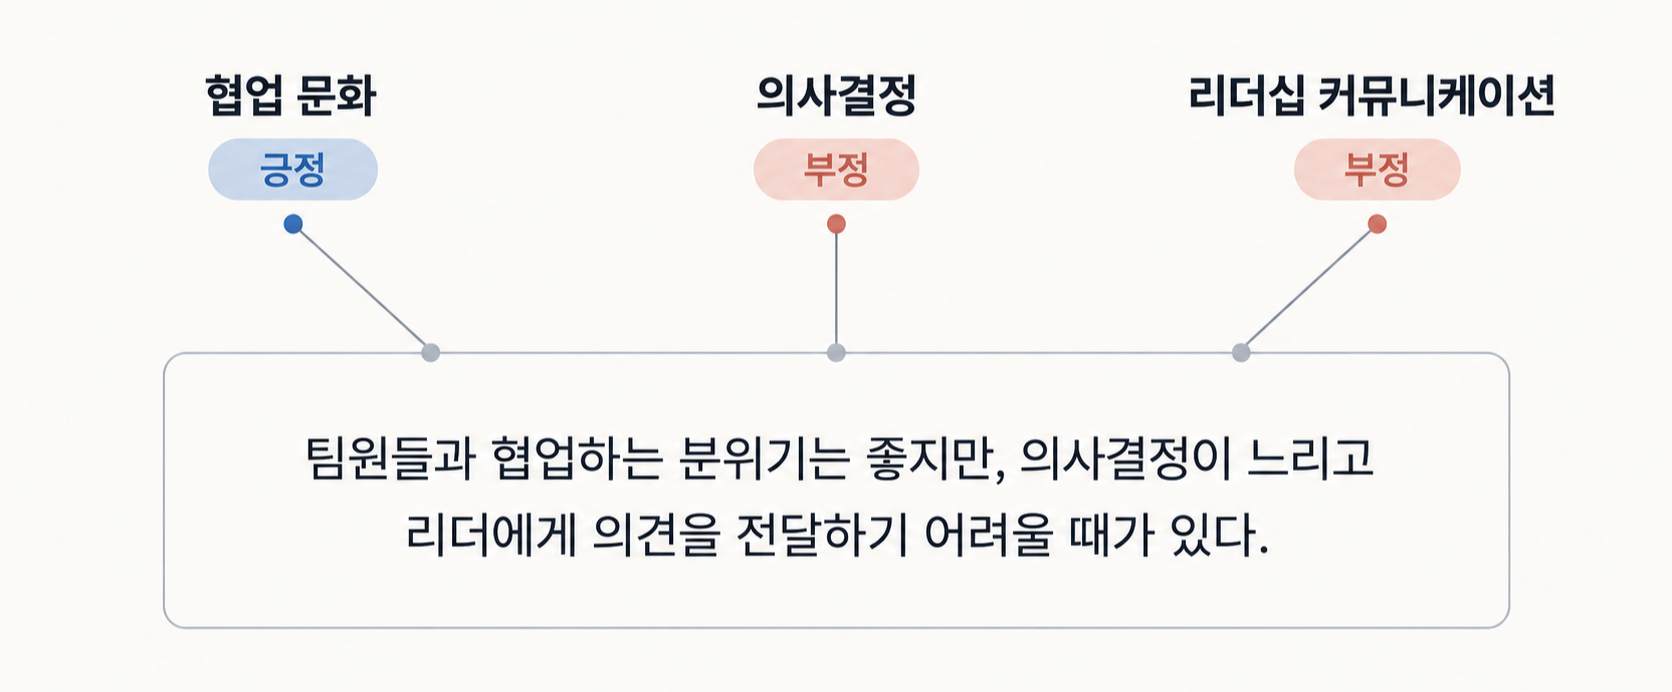
팀원들과 협업하는 분위기는 좋지만, 의사결정이 느리고 리더에게 의견을 전달하기 어려울 때가 있다.
이 짧은 응답 안에는 세 가지 맥락이 존재한다.
협업 문화에 대한 긍정적인 경험, 의사결정 방식에 대한 부정적인 경험, 그리고 리더십 커뮤니케이션에 대한 부정적인 경험이다.
주제와 감정을 분석하려면 하나의 응답 안에 존재하는 서로 다른 의미 단위를 구분해야 했다.
어디에서 나눌 것인가
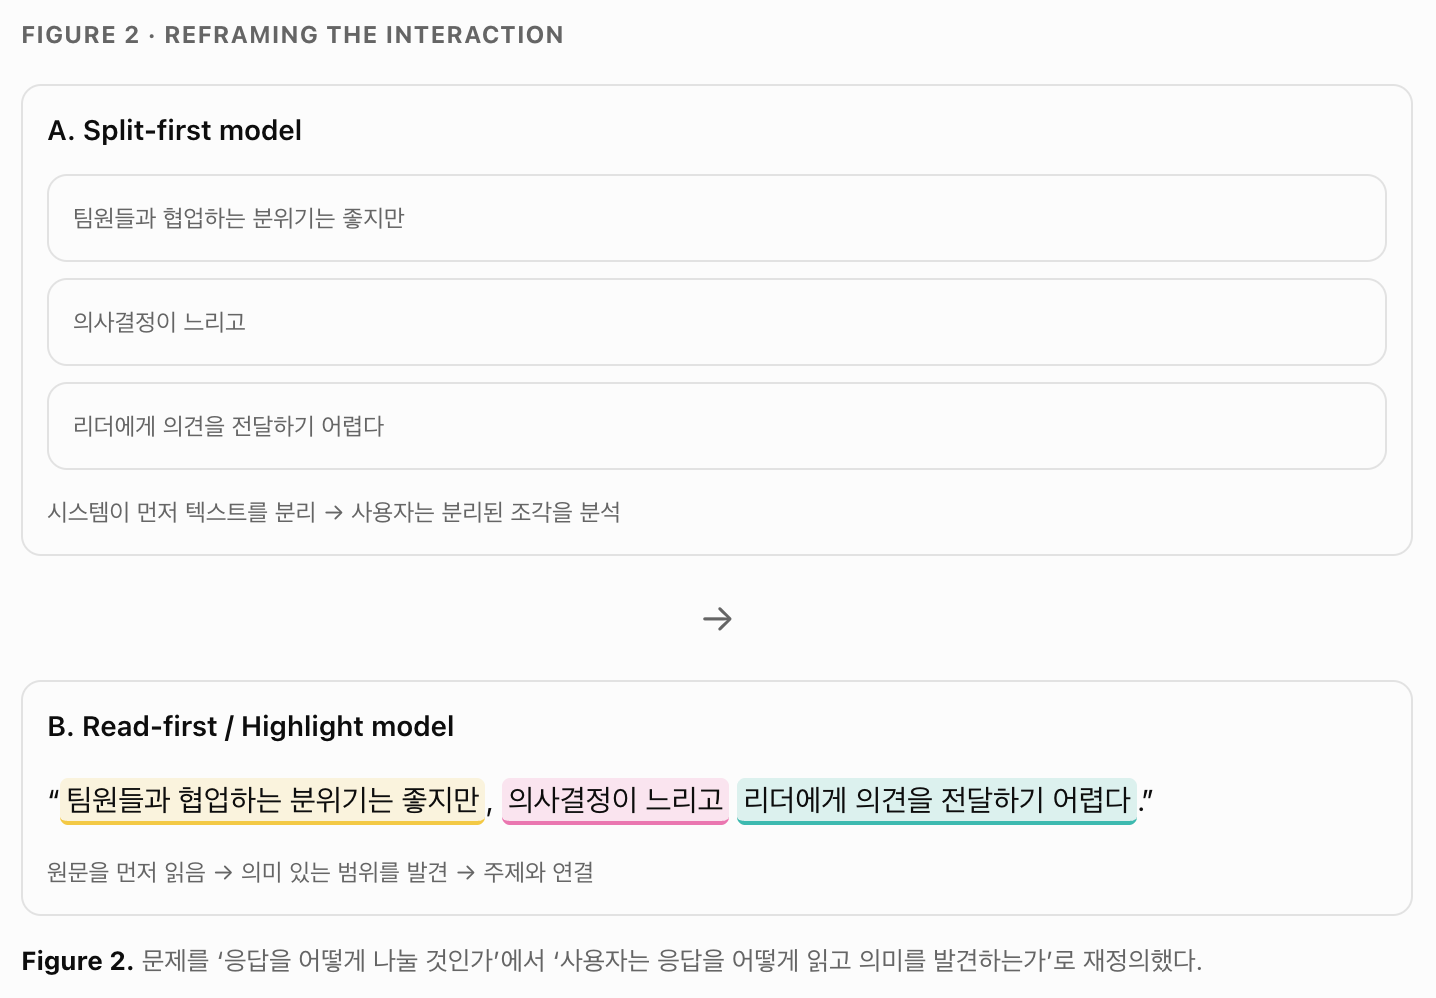
처음에는 자연스럽게 하나의 응답을 여러 분석 단위로 분리하는 Split 방식을 생각했다.
앞의 응답은 다음과 같이 세 개의 응답으로 분리해 데이터로 만들 수 있다.
팀원들과 협업하는 분위기는 좋다.
의사결정이 느리다.
리더에게 의견을 전달하기 어렵다.
이 방식에는 명확한 장점이 있었다.
분리된 각각의 문장을 하나의 observation으로 취급할 수 있기 때문에 데이터 구조가 단순해진다. 각 segment에 topic과 sentiment를 연결하면 검색과 필터링, 빈도 집계도 쉬워진다.
이후에 고려할 주관식 자동 분석에서도 마찬가지다.
text → topic, text → sentiment 형태의 비교적 명료한 classification 문제로 정의할 수 있다.
긴 문장을 짧게 나누면 각각의 내용을 분류하거나 요약하기가 쉬워진다. 시스템 입장에서는 한 번에 처리해야 할 정보도 단순해진다.
하지만 문장을 잘게 나누면 다른 문제가 생긴다. "하지만," "그래서," "반면에"처럼 앞뒤 내용의 관계를 보여주는 정보가 약해질 수 있기 때문이다.
즉, 문장을 나누는 것은 분석을 쉽게 만들지만, 나눈 뒤에도 원래 문맥과 관계를 어떻게 유지할지는 새로운 고민이 따라온다.
Split은 분류하기 좋은 데이터를 만드는 데 강한 구조였다.
하지만 제품 관점에서 다시 보면 다른 질문이 생겼다.
분석하기 편한 데이터 구조와 사람이 실제로 응답을 이해하는 방식은 같은가?
Split은 의미의 경계를 먼저 결정한다
Split에는 하나의 중요한 전제가 존재한다.
먼저 의미의 경계를 확정할 수 있어야 한다는 것이다.
그러나 실제 조직 경험은 항상 깔끔하게 분리되지는 않았다.
예를 들어 다음 응답을 생각해볼 수 있다.
리더가 구성원의 의견을 듣기는 하지만, 실제 결정에는 반영되지 않는 것 같다.
이를 두 개의 문장으로 분리하면 다음과 같이 해석할 수 있다.
리더가 구성원의 의견을 듣는다.
→ Leadership Communication / Positive
실제 결정에는 반영되지 않는다.
→ Decision Making / Negative
각각의 문장은 분류하기 쉬워졌지만, 중요한 정보가 약해진다.
이 응답의 핵심은 단순히 '의견을 듣는다'와 '결정에 반영하지 않는다'는 두 사실이 아니다.
"듣기는 하지만 반영되지는 않는다"는 두 경험 사이의 관계가 중요한 정보일 수 있다.
문장을 짧게 만드는 것은 각각의 단위를 처리하기 쉽게 만들 수 있지만, 분석자는 떨어져 있는 정보 사이의 관계를 다시 복원해야 한다.
local cognitive load ↓, contextual reconstruction cost ↑
따라서 Split에는 두 종류의 비용이 존재한다.
하나는 segment 자체를 처리하는 비용, 다른 하나는 segment 사이의 맥락을 다시 연결하는 비용이다.
실제 분석 행위는 '분리'보다 '읽기와 발견'에 가까웠다
여기에서 분석 단위가 아니라 분석자의 행동을 다시 살펴봤다.
HR 담당자가 주관식 응답을 처음부터 기계적으로 잘라 읽는다고 보기는 어려웠다.
먼저 구성원이 작성한 응답 전체를 읽는다.
그 안에서 반복적으로 등장하는 조직 경험을 찾거나, 특정 조직 주제와 관련된 표현을 발견하거나, 예상하지 못했던 문제를 파악한다.
행동을 단순화하면 다음 순서에 가까웠다.
Read → Interpret → Select → Label
즉 먼저 응답을 읽고 의미를 해석한 뒤, 의미 있다고 판단한 부분을 선택하고 마지막으로 주제와 감정을 연결한다.
이 관점에서 문제를 다시 정의해보니 질문이 달라졌다.
"어떻게 응답을 잘 나눌 것인가?"가 아니라 "응답을 읽으면서 발견한 의미를 어떻게 남길 수 있을까?"가 되었다.
e-book의 Highlight 경험을 분석 도구로 가져오기
이때 떠올린 인터랙션이 e-book에서 사용하던 Highlight였다.
책을 읽을 때 독자는 텍스트를 먼저 분리하지 않는다.
전체 문맥을 유지한 상태에서 읽다가 자신에게 의미 있는 표현을 발견하면 해당 범위를 선택한다.
주관식 응답도 같은 방식으로 다룰 수 있다고 생각했다.
응답 원문은 유지한다. 그리고 분석자가 의미 있다고 판단한 범위를 직접 선택해 주제나 키워드를 연결하도록 한다.
앞의 응답이라면 다음과 같이 표현할 수 있다.
팀원들과 협업하는 분위기는 좋지만
→ 협업 문화 / Positive
의사결정이 느리고
→ 의사결정 / Negative
리더에게 의견을 전달하기 어려울 때가 있다
→ 리더십 커뮤니케이션 / Negative
Split 방식과의 중요한 차이는 원문 자체를 변경하지 않는다는 것이다.
Split이 원문을 새로운 분석 단위로 변환한다면, Highlight는 원문을 source of truth로 남겨두고 그 위에 분석자의 해석을 annotation layer로 추가한다.
Highlighting에 관한 인지 연구를 이 제품의 직접적인 검증 결과로 사용할 수는 없지만, 참고할 만한 특징은 있었다.
Eye-tracking 연구에서는 highlighting이 독자가 특정 정보를 선택하는 과정과 관련된 것으로 관찰되었지만, highlighting만으로 깊은 comprehension이 향상된 것은 아니었다.
“Highlight가 인간의 이해력을 높여준다”고 정의하기보다는, 분석자가 읽으면서 중요하다고 판단한 부분을 선택하는 행동을 인터페이스에 보존하는 방식으로 보는 것이 더 적절하다.
Highlight는 더 자연스러웠지만 단순하지는 않았다
Highlight를 선택한다고 모든 문제가 해결되는 것은 아니었다. 오히려 기술적으로는 Split보다 훨씬 복잡해졌다.
Split에서는 하나의 분석 결과를 비교적 단순하게 표현할 수 있다.
segment → topic → sentiment
Highlight에서는 원문과 annotation을 분리해야 한다.
source response + selected range + topic + sentiment
예를 들면 다음과 같다.
response_id: 1024
start: 18
end: 34
topic: leadership
sentiment: negative
이 구조에서는 텍스트 범위 자체가 데이터가 된다. 프론트엔드에서도 추가적인 과제들이 발생한다.
텍스트 selection을 안정적으로 처리해야 하고, 이미 만들어진 annotation을 수정하거나 삭제할 수 있어야 한다.
하나의 텍스트에 여러 annotation이 겹칠 경우 DOM에서 이를 어떻게 표현할 것인가도 해결해야 한다.
즉, Highlight는 사용자의 읽기 경험을 보존하는 대신 interaction과 data model의 복잡성을 증가시키는 선택이었다.
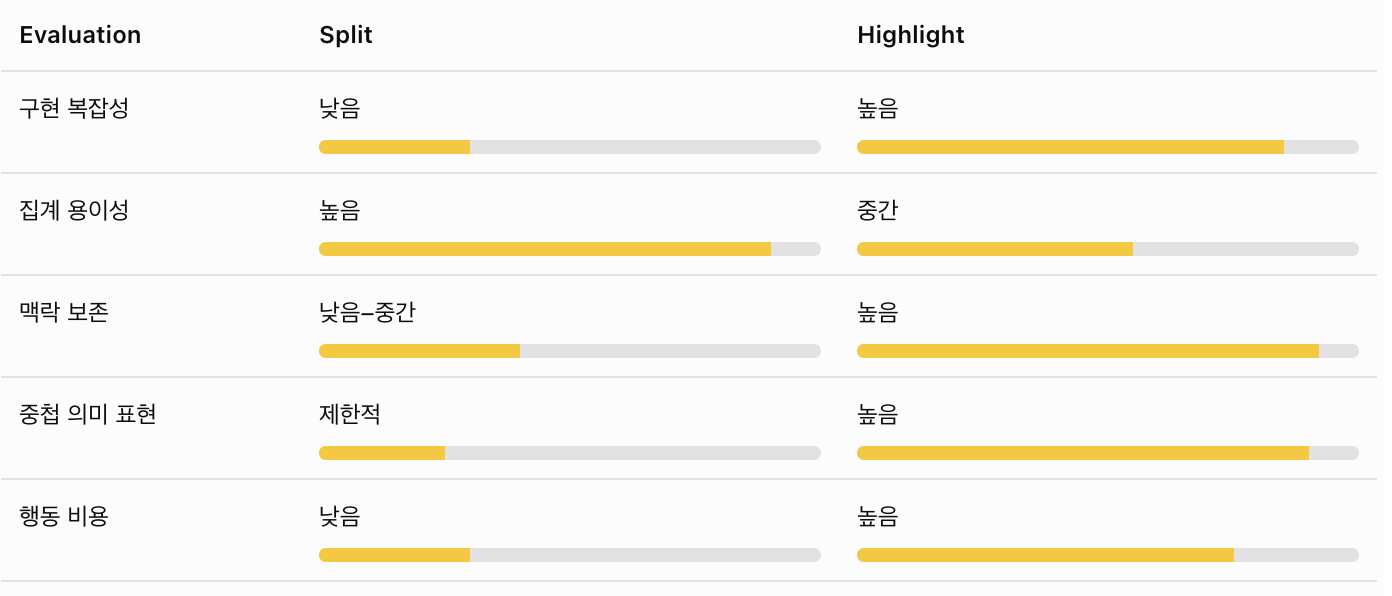
Split은 단순하지만 원문을 훼손할 수 있었고, Highlight는 원문 맥락과 분석자의 판단 근거를 보존하는 데 강하다. 선택의 기준은 구현 복잡성보다 분석 작업의 목적이었다.
의미는 항상 서로 배타적이지 않았다
Highlight를 고려하면서 또 하나의 문제가 나타났다. 하나의 표현이 반드시 하나의 주제에만 속하는 것은 아니었다.
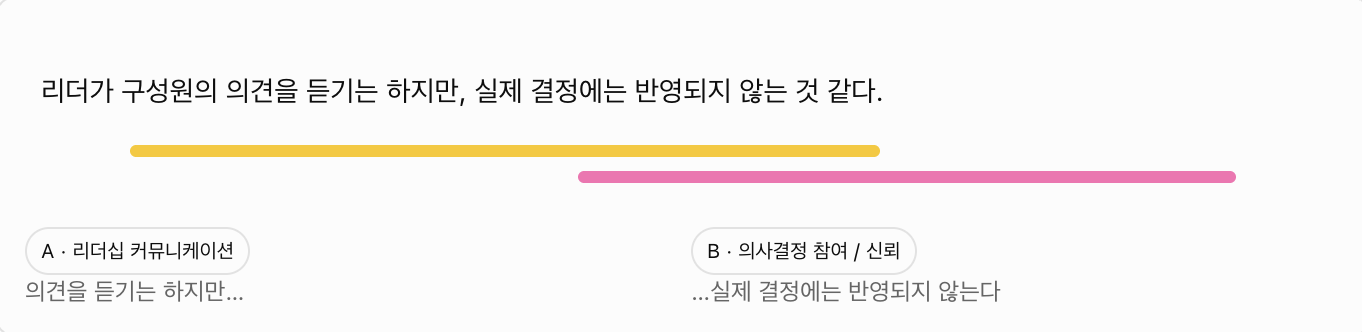
리더가 구성원의 의견을 듣기는 하지만, 실제 결정에는 반영되지 않는 것 같다.
이 응답에서 "구성원의 의견을 듣는다"는 표현은 리더십 커뮤니케이션과 관련될 수 있다.
"실제 결정에는 반영되지 않는다"는 부분은 의사결정 참여와 관련될 수 있다.
전체 표현은 동시에 리더십 신뢰와 연결될 수도 있다.
텍스트를 서로 배타적인 구역으로 나누는 방식만으로는 실제 분석자가 사용하는 의미 구조를 충분히 표현하기 어렵다고 판단했다.
그래서 서로 겹치는 범위를 annotation할 수 있는 구조도 고려했다.
우리가 알고 싶은 것도 단순히 '이 응답은 긍정인가, 부정인가?' 가 아니었다.
어떤 조직 경험에 대해, 어느 표현에서, 어떤 감정이 나타났는가? 에 더 가까웠다.
사용자 행동 자체가 데이터가 될 수 있었다
이 시점부터 Highlight의 의미가 조금 달라졌다. 단순히 읽기 편한 인터랙션이 아니었다.
사용자가 분석 과정에서 만들어내는 선택 자체가 새로운 데이터가 될 수 있었다.
분석자가 응답을 읽으며 Highlight를 하면 정보가 남는다.
어떤 텍스트를 하나의 의미 단위로 판단했는지, 어느 주제와 연결했는지, 어떤 sentiment로 해석했는지, 하나의 응답 안에서 몇 개의 맥락을 구분했는지, 그리고 어떤 의미들이 서로 중첩된다고 판단했는지 알 수 있다.
즉, Split에서는 보통 분리된 결과가 데이터라면, Highlight에서는 어디를 분리해야 한다고 판단했는가까지 데이터가 된다.
이 차이는 상당히 중요했다.
당시 자동 분석 기능을 고도화하려면 학습 데이터가 필요했지만, 실제 조직 문화 진단 데이터를 충분히 확보하기는 어려운 일이었다.
그렇다보니, 영화 리뷰 코멘트와 같이 제품의 실제 도메인과 관계가 적은 데이터를 이용해 학습 데이터를 준비하는 방향도 고려되고 있었다.
하지만 영화 리뷰와 HR 서베이는 언어의 목적부터 다르다.
영화 리뷰는 작품에 대한 평가가 중심이지만, HR 서베이는 실제 업무 환경, 조직 관계, 리더십, 협업, 보상, 성장 등의 경험을 기술한다.
무엇보다 우리가 필요로 했던 것은 단순한 positive/negative 문장 집합이 아니었다.
실제 HR 담당자가 어떤 표현을 하나의 조직 맥락으로 판단하는가에 대한 정보가 필요했다.
Highlight interaction은 이를 제품 사용 과정에서 자연스럽게 축적할 수 있는 기반이 될 수 있었다.
Highlighting 행동이 독자의 판단에 관한 신호가 될 가능성을 살펴본 다른 분야의 연구도 도움이 되었다. 교육 환경에서 사용자가 선택한 highlight pattern을 이용해 독자의 이해도나 관심을 추론할 수 있는지를 분석한 연구에서는 highlight 자체가 단순 표시를 넘어 사용자 판단을 나타내는 behavioral data가 될 가능성을 이야기한다.
물론 HR 분석에서도 동일한 효과가 있다고 볼 수는 없지만, 서베이 결과를 리포트로 가공하여 공유하는 경우 효과가 있을 것으로 내다보았다. 그보다 이 사례에서 중요한 것은 Highlight를 표현 방식뿐 아니라 데이터 생성 행위로 바라보기 시작했다는 점이다.
UX 결정이 데이터 전략으로 연결됐다
이 구조에서는 다음과 같은 과정이 만들어진다.
서베이 응답
→ 분석 담당자가 원문을 읽음
→ 의미 있는 범위를 Highlight
→ Topic / Sentiment 연결
→ Domain annotation 축적
→ 자동 분석의 고도화
결론적으로 Interaction as a data collection loop가 이루어진다.
사용자의 분석 행동을 별도의 labeling task로 분리하지 않고 제품 사용 과정에 포함시킨다. 이를 통해 실제 도메인 언어와 분석자의 판단을 함께 축적할 수 있는 구조를 만든다.
여기에서 얻을 수 있는 데이터는 단순한 keyword 목록과 조금 다르다.
실제 조직 문화 진단에서 사용되는 표현과, 해당 표현의 텍스트 범위, 연결된 주제와 sentiment, 하나의 응답 안에서 함께 등장하는 여러 맥락, 주제 간 중첩 관계를 함께 보존할 수 있다.
사용자에게 자연스러운 분석 경험을 제공하기 위한 결정이 동시에 도메인에 적합한 학습 데이터를 확보할 수 있는 제품 구조로 연결될 수 있었다.
Split optimizes categorization. Highlight preserves interpretation.
처음 문제를 봤을 때 가장 중요한 질문은 “텍스트를 어디에서 나눌 것인가?” 라고 생각했다.
하지만 제품을 설계하면서 질문이 바뀌었다.
“사람은 주관식 응답에서 어떻게 의미를 발견하는가?”
Split은 분석 단위를 명확하게 만들어 분류와 집계를 단순화한다.
반면 Highlight는 구현과 데이터 처리의 복잡성을 증가시키지만, 원문을 유지하면서 분석자가 어떤 표현을 왜 하나의 의미로 판단했는가를 함께 보존할 수 있다.
이 사례에서 Highlight는 단순히 e-book에서 가져온 익숙한 interaction pattern이 아니었다.
맥락을 유지하면서 분석 단위를 생성하는 방법이다.
그 선택은 인터랙션을 넘어 데이터 모델과 향후 자동 분석 기능을 위한 학습 데이터 전략까지 영향을 미쳤다.
제품의 인터랙션과 데이터 구조는 항상 서로 분리되어 있지 않다.
경우에 따라 좋은 인터랙션은 사용자가 해야 할 일을 쉽게 만드는 것을 넘어,
제품을 사용하는 과정 자체가 더 나은 제품을 만들기 위한 데이터를 생성하도록 설계될 수 있다.
note
Highlight가 Split보다 인지적으로 우월하다고 결론 내리기보다, 분석의 목적, 보존해야 하는 정보, 사용자의 행동, 그리고 향후 필요한 데이터에 따라 적합한 interaction model이 달라진다는 것이 이 사례의 핵심이다.
'개발 > 기타' 카테고리의 다른 글
| 효율을 가장한 비효율 (0) | 2026.07.12 |
|---|---|
| AI는 실력을 대신해주지 않고, 드러낸다. (0) | 2026.01.24 |
| 붙잡기보다 흘려보내기 (0) | 2025.09.02 |
| 잘못된 설계가 남긴 것 (1) | 2025.08.08 |
| AI 시대, 사고의 외주화와 인간의 역할 (0) | 2025.05.28 |